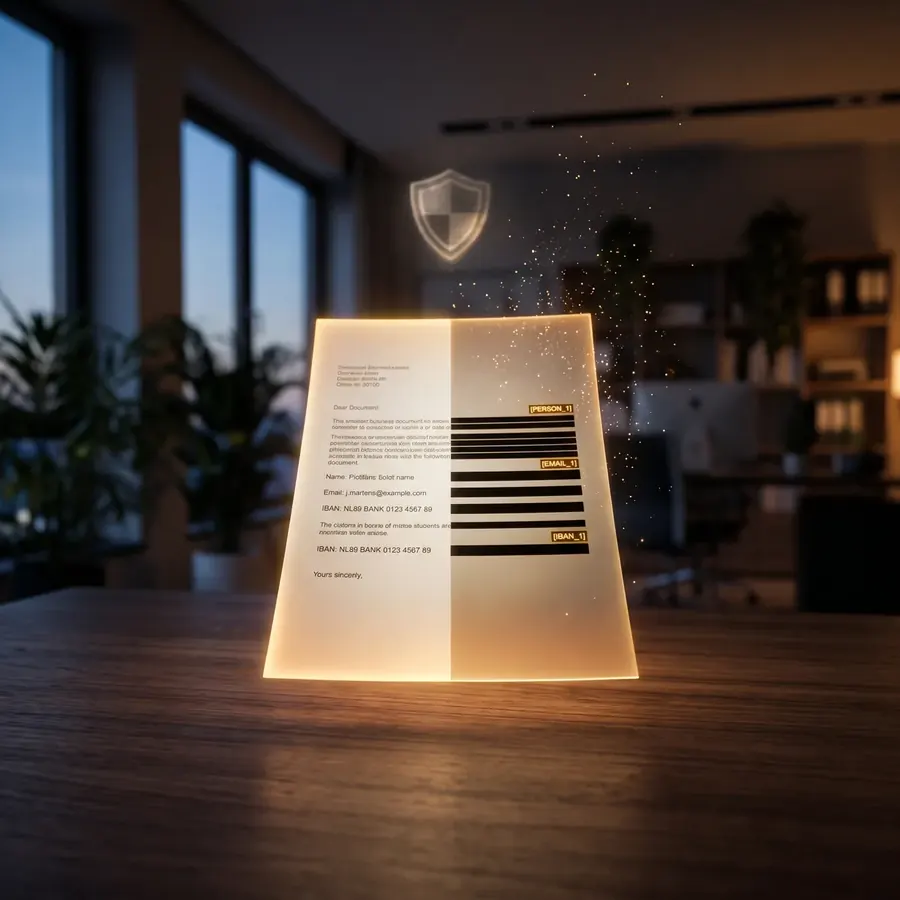
Las nóminas, los contratos, las notas de entrevistas y la correspondencia con clientes pueden contener información sensible. La censura de documentos ayuda a retirar la información seleccionada de la versión que se pretende compartir o procesar. El enmascaramiento reversible y la censura permanente tienen finalidades distintas: ninguno demuestra automáticamente que un resultado sea anónimo o que un uso posterior sea lícito.
Esta es la referencia extensa que nos habría gustado encontrar cuando construimos Redactic. Cubre qué es realmente la ocultación de datos y qué no es, cómo la encuadra el RGPD (pseudonimización del artículo 4(5) versus anonimización del Considerando 26), los dos modos operativos que usarás en la práctica, las categorías de PII que deben enmascararse antes de cualquier uso de IA, un procedimiento de cinco pasos que sirve tanto para un único PDF como para un libro de nóminas con varias hojas, el riesgo real que el shadow AI supone para el RGPD dentro de los despachos profesionales, una lista de comprobación de ocho puntos para elegir una herramienta y unas preguntas frecuentes con las dudas que los clientes nos hacen cada semana.
Puedes leer el artículo de principio a fin — está escrito para ser escaneable — o saltar a la sección que coincida con tu problema inmediato. Si en tu despacho ya tuvisteis la conversación de "qué hacemos con ChatGPT" y la perdisteis, empieza por la sección de shadow AI. Si tu preocupación son las inspecciones de la AEPD, empieza por el marco RGPD.
1. Qué es la ocultación de datos y qué no es
La ocultación de datos es el proceso de identificar información personal o sensible dentro de un documento y eliminarla de la versión que después se compartirá, procesará o archivará. El término proviene de la práctica legal de tachar pasajes de expedientes antes de su publicación; en flujos digitales cubre un conjunto mucho más amplio de operaciones, desde sustituir un nombre con un marcador hasta destruir permanentemente una región de una imagen con un ennegrecimiento preciso al píxel.
A menudo se usan "ocultación", "anonimización", "pseudonimización", "enmascaramiento", "cifrado" y "borrado" como sinónimos. No lo son, y la diferencia pesa bajo el RGPD. Volveremos a los matices jurídicos en la sección 2; por ahora ten en mente estas distinciones.
- La ocultación es la operación paraguas: convertir un documento que contiene PII en una versión que ya no las contiene (o ya no de una forma que atacantes o lectores no autorizados puedan recuperar).
- El enmascaramiento (también llamado enmascaramiento de datos o máscara de datos) es una técnica: sustituir cada fragmento de PII detectado por un marcador como
[PERSONA_1]o⟦NOMBRE⟧. El marcador tiene sentido para el proceso posterior (por ejemplo un LLM), pero no contiene en sí ningún identificador. - La pseudonimización es enmascaramiento más una correspondencia de retorno guardada por separado. El RGPD la reconoce explícitamente en el artículo 4(5) y la premia a lo largo del texto, pero no convierte los datos en datos "anónimos".
- La anonimización es unidireccional e irreversible. Después de anonimizar nadie — tú incluido — debería poder re-identificar al sujeto. El RGPD coloca el listón en el Considerando 26 y los datos anónimos quedan fuera del ámbito del reglamento.
- El cifrado es reversible por cualquiera con la clave. Las PII cifradas siguen siendo datos personales bajo RGPD; el cifrado es un control de seguridad, no una técnica de ocultación.
- El borrado elimina el documento; la ocultación elimina las PII de un documento que se conserva.
Elige la censura permanente cuando la información sensible seleccionada deba eliminarse del documento compartido. Elige el enmascaramiento reversible cuando un flujo compatible necesite marcadores y una restauración posterior. En ambos casos, evalúa el contexto restante y los identificadores indirectos. La censura permanente no demuestra automáticamente la anonimización.
El otro error que vemos constantemente es tratar la ocultación como un paso puntual antes de compartir un archivo. En un despacho con muchos usuarios, carpetas compartidas, uso semanal de LLM y subcontratistas externos, la ocultación tiene que formar parte del flujo de trabajo: al subir el archivo, en el momento de la petición a la IA y al exportar. Una revisión mensual a mano de un becario con un rotulador negro no basta.
2. El marco del RGPD: pseudonimización (artículo 4(5)) y anonimización (considerando 26)
Tres referencias RGPD estructuran toda conversación seria sobre la protección de datos personales mediante ocultación en la UE.
El apartado 5 del artículo 4 del RGPD define la pseudonimización como "el tratamiento de datos personales de manera tal que ya no puedan atribuirse a un interesado sin utilizar información adicional". La información adicional debe "conservarse por separado y estar sujeta a medidas técnicas y organizativas destinadas a garantizar que los datos personales no se atribuyan a una persona física identificada o identificable". Los datos pseudonimizados siguen siendo datos personales: el RGPD sigue aplicando, sigue haciendo falta base jurídica, y el interesado conserva los derechos de acceso y supresión. Esta es la pseudonimización en el sentido estricto del RGPD, la que muchos textos citan simplemente como artículo 4.
El Considerando 26 del RGPD traza la línea para la anonimización: "los principios de protección de datos no deben aplicarse a la información anónima, es decir, información que no guarda relación con una persona física identificada o identificable, ni a los datos convertidos en anónimos de forma tal que el interesado no sea o ya no pueda ser identificable". Los datos anónimos están fuera de ámbito. El listón es alto y se entiende mejor a través de los tres criterios del Dictamen 05/2014 WP29: singling out (aislamiento), linkability (vinculabilidad), inference (inferencia). Si un documento con los datos ocultos todavía permite aislar un individuo, vincular registros entre conjuntos de datos o inferir atributos de una persona específica, has pseudonimizado, no anonimizado. La anonimización que alcanza el umbral legal del RGPD es más rara de lo que sugiere el material de marketing.
El artículo 25 del RGPD (Protección de datos desde el diseño y por defecto) y el artículo 32 (Seguridad del tratamiento) empujan juntos la pseudonimización como medida técnica prudente para tratamientos arriesgados. El art. 32.1.a) la nombra expresamente. Por eso un programa de cumplimiento que ha invertido en una pseudonimización correcta es premiado por las autoridades de control: es un control que el propio reglamento prescribe por nombre.
El Reglamento de IA de la UE (AI Act), en vigor desde 2024 con disposiciones de alto riesgo escalonadas entre 2026 y 2027, añade otro nivel de exigencia. Los sistemas de IA usados para RR. HH. (selección, evaluación del desempeño, decisiones de promoción) se clasifican como de alto riesgo en el Anexo III. Exigen gestión de riesgos, gobernanza de datos, documentación técnica, transparencia, supervisión humana, controles de exactitud/robustez/ciberseguridad y una evaluación de impacto sobre los derechos fundamentales. En la práctica, el RGPD y el AI Act forman un único modelo operativo. El uso de la inteligencia artificial conforme al RGPD, la conformidad con el AI Act y la ocultación de datos en los documentos pasan por el mismo proceso de pseudonimización preventiva, porque satisface a la vez la minimización (art. 5 RGPD) y la gobernanza de datos del AI Act (art. 10).
Un mito que hay que matar: muchos proveedores comercializan su herramienta como "anonimización RGPD" cuando es, de hecho, pseudonimización. Si la correspondencia entre el marcador y el valor original existe en algún sitio (en tu sistema de archivos, en el navegador del usuario o en un servicio que operamos), los datos están pseudonimizados y no son anónimos. La pseudonimización prevista por el RGPD es una salvaguarda útil, y no hay nada de malo en ofrecerla; llamarla anonimización es engañoso y expone al cliente a una trampa de cumplimiento. El certificado de Redactic distingue explícitamente las dos y etiqueta cada trabajo reversible como pseudonimización al amparo del art. 4(5).
La jurisprudencia ha estrechado aún más la línea. En Breyer c. Alemania (C-582/14, 2016) el TJUE estableció que una dirección IP en manos del operador de un sitio web es un dato personal si el operador tiene medios legales razonables para obtener la información identificativa adicional de un tercero. El test de "medios razonables" es más amplio de lo que muchos ingenieros suponen: datos que tu servicio por sí solo no puede identificar pueden seguir siendo personales si una orden judicial o un acuerdo contractual puede aportar las piezas que faltan. Para la ocultación esto significa que repartir marcadores y correspondencias entre dos organizaciones no equivale automáticamente a anonimizar: si una de las partes puede obligar legalmente a la otra a revelar la correspondencia, los datos están pseudonimizados para ambas. La sentencia 2023 SRB c. EDPS (T-557/20) reforzó la naturaleza contextual del test distinguiendo datos pseudonimizados en manos de un destinatario que no puede re-identificar de los mismos datos en manos del responsable que sí puede.
El Dictamen 05/2014 WP29 (hoy adoptado por el EDPB) operacionaliza el Considerando 26 con tres modelos de ataque concretos. Singling out: ¿puede un atacante aislar un registro correspondiente a un individuo? Linkability: ¿pueden dos registros del mismo conjunto de datos, o de conjuntos diferentes, vincularse al mismo individuo? Inference: ¿puede deducirse el valor de un atributo de la combinación de los otros? Si la respuesta a una cualquiera es sí, el documento está pseudonimizado, no anonimizado. La conclusión práctica es que enmascarar el nombre en una hoja de nóminas no la anonimiza — la fila sigue aislando a un único empleado — y que el caso genuinamente anónimo es más raro de lo que los proveedores dejan entrever. El considerando 26 del RGPD fija un listón muy difícil de superar y no ofrece ninguna receta para sentirse seguro.
3. Los dos modos: reversible (mapa de marcadores) e irreversible (ennegrecimiento)
En producción usarás constantemente dos modos. Entender la diferencia es lo que separa un flujo de trabajo que supera una inspección y uno que filtra nombres porque usaste la herramienta equivocada para la tarea.
El enmascaramiento reversible sustituye los valores sensibles detectados por marcadores y utiliza una tabla de correspondencias separada para restaurarlos en los flujos compatibles. Protege esa tabla y revisa el texto preparado antes de cualquier tarea opcional de IA. Los valores no detectados y la información contextual aún pueden permitir identificar a personas.
Las tablas de correspondencias para la restauración necesitan protección y una política de conservación definida. Según el flujo, el procesamiento puede implicar un estado temporal en el servidor además de la restauración local. Redactic no afirma que el contenido original o las correspondencias permanezcan siempre en el navegador. Consulta el DPA aplicable para conocer las obligaciones de conservación y eliminación.
La censura permanente elimina la información sensible seleccionada del documento exportado. En escaneos e imágenes, el OCR puede ayudar a localizar el texto que debe revisarse. Examina el resultado para detectar valores omitidos, información oculta e identificadores indirectos. Eliminar determinadas zonas de texto o imagen no demuestra por sí solo que el contenido restante ya no permita identificar a las personas.
El error que vemos más a menudo es el inverso: un despacho ejecuta una pasada de "anonimización" que en realidad es enmascaramiento reversible, comparte el archivo externamente y conserva la correspondencia en un drive compartido al que el destinatario acaba teniendo acceso. Resultado: un registro re-identificable en el servidor de un tercero. Elige el modo en función del destino, no por costumbre.
Redactic ofrece enmascaramiento reversible y censura permanente en los flujos compatibles. Los formatos de exportación disponibles y la conservación de la maquetación dependen del documento de entrada y la operación elegida. Comprueba el resultado con un archivo representativo; no supongas que el enmascaramiento reversible conserva un PDF en su formato original.
4. Categorías de datos personales que deben ocultarse antes de usar IA
No todo dato personal tiene el mismo peso regulatorio. El RGPD distingue entre "datos personales" (art. 4.1) — todo lo que identifique o pueda identificar a una persona física — y "categorías especiales" (art. 9) como datos de salud, identificadores biométricos, origen racial o étnico, opiniones políticas, convicciones religiosas, afiliación sindical, orientación sexual y datos genéticos. Para las categorías especiales el listón para tratar es mucho más alto (consentimiento explícito, intereses vitales, interés público en salud, etc.) y el riesgo de divulgación involuntaria del lado LLM es proporcionalmente mayor. Los datos personales de estas categorías contenidos en un PDF nunca deben tratarse en claro fuera del entorno controlado.
La tabla siguiente es la lista de comprobación operativa que usamos. Antes de que un documento vaya a ChatGPT, Claude, Gemini, Mistral o cualquier otro proveedor LLM, cada entrada debajo debe estar enmascarada con un marcador o ennegrecida, según el flujo de trabajo necesite o no reversibilidad.
| Categoría | Ejemplos | Por qué importa |
|---|---|---|
| Identificadores directos | Nombre completo, email, teléfono, dirección postal | El conjunto mínimo de PII; re-identificación trivial. |
| Identificadores nacionales | DNI/NIE español, NIR/INSEE francés, Codice Fiscale italiano, Steuer-ID alemán, números de pasaporte UE | Los identificadores específicos de cada país requieren una cobertura adecuada y revisión humana. Reconocer el formato de un identificador no valida necesariamente el identificador ni demuestra a quién pertenece. |
| Financieros | IBAN, SWIFT, números de tarjeta, cuenta bancaria, CIF/NIF | Disparan riesgo PCI-DSS adyacente y riesgo de fraude directo. |
| Empleo | ID de empleado, línea de nómina, fecha de alta, retribución, valoración | Re-identifican dentro de una organización pequeña incluso sin nombre. |
| Salud (art. 9) | Diagnósticos, medicación, motivos de baja, notas de medicina del trabajo | Categoría especial, requiere consentimiento explícito u otra base del art. 9. |
| Biométricos / documentos de identidad | Números de DNI, permiso de conducir, pasaporte, fotografías faciales | Categoría especial si se usan para identificación unívoca. |
| Cuasi-identificadores | Fecha de nacimiento + CP + género, rol+departamento exacto, título raro | Usados en ataques de linkage. Regla de Sweeney al 87 %: CP+DOB+género re-identifica a la mayoría de los adultos en EE. UU. |
| Divulgaciones en texto libre | Transcripciones de entrevistas de salida, reclamaciones de clientes, tickets de soporte | La categoría más difícil. Suele escapar a las herramientas basadas en patrones y necesita NER ML. |
La detección automática de información personal puede combinar técnicas basadas en patrones y aprendizaje automático para localizar información potencialmente sensible. Redactic combina detección automática, procesamiento documental y revisión humana en infraestructura controlada por Redactic en Europa. Durante la detección y la censura, el contenido sin censurar no se envía a servicios de inferencia de IA o aprendizaje automático de terceros. La precisión depende de la calidad del documento, el idioma y el contexto.
El OCR hace que el texto de escaneos e imágenes compatibles esté disponible para su detección y revisión. La baja resolución, la rotación, la escritura manuscrita y las maquetaciones complejas pueden afectar al resultado. Revisa todas las páginas pertinentes y el documento exportado; la compatibilidad con OCR no garantiza que se encuentre cada dato sensible.
Los informes compuestos en gran parte por datos de salud exigen el mismo cuidado, y Redactic muestra cómo los psicólogos pueden tachar datos en informes periciales psicológicos antes de entregarlos a abogados, colegios o al juzgado.
5. Un procedimiento de cinco pasos para grandes volúmenes
Un flujo de censura reproducible combina selección del documento, detección automática, revisión humana, aplicación y verificación del resultado. Los cinco pasos siguientes ofrecen un punto de partida práctico; adáptalos a los requisitos de gestión de datos y aprobación de tu organización.
- Carga. Selecciona un documento compatible y confirma que tienes autorización para tratarlo. En el SaaS estándar, el documento original se carga en Redactic para su procesamiento en Europa. La detección y la censura no envían contenido sin censurar a servicios de inferencia de IA de terceros.
- Detección. Identifica posibles nombres, datos de contacto, información financiera e identificadores nacionales pertinentes. En escaneos e imágenes, el reconocimiento de texto puede ayudar a localizar la información. Trata las detecciones como sugerencias que requieren revisión.
- Revisión. Examina los valores detectados, corrige los falsos positivos y busca información sensible que se haya pasado por alto. Presta especial atención a los identificadores contextuales, los escaneos de baja calidad, las tablas y las variaciones ortográficas.
- Aplicación. Elige censura permanente o enmascaramiento reversible según el destino previsto. Protege las tablas de restauración cuando se utilicen. Comprueba las propiedades y la información oculta del documento, además del texto visible; las limitaciones específicas del formato importan.
- Compartir o restaurar. Revisa el documento exportado antes de compartirlo. Si eliges un flujo opcional de IA, comprueba primero el contenido preparado y las condiciones del proveedor. Restaura los valores únicamente en un flujo compatible con una tabla de correspondencias debidamente protegida. Conserva registros de operaciones adecuados para tus requisitos de auditoría.
Un certificado de censura puede complementar tus registros de operaciones con hashes de documentos y resúmenes de las eliminaciones. No demuestra que se haya detectado cada valor sensible, no acredita la anonimización ni prueba por sí solo que no se haya conservado ninguna copia del documento. Comprueba los campos reales del certificado frente a tus requisitos de auditoría.
Por ejemplo, un equipo de nóminas puede revisar un libro con varias hojas para localizar nombres de empleados, identificadores fiscales, datos bancarios y notas sensibles. Confirma las detecciones, corrige los valores omitidos y elige enmascaramiento reversible o censura permanente según corresponda. Antes de compartirlo, comprueba el libro exportado, incluidas las fórmulas, las celdas numéricas, las hojas ocultas, los comentarios y las propiedades. Este ejemplo ilustra un flujo de trabajo, no una garantía de precisión o de tiempos de procesamiento medidos.
6. Shadow AI: por qué usar ChatGPT sin control vulnera el RGPD
La conversación que tenemos más a menudo con clientes empieza así: "Prohibimos ChatGPT para datos sensibles. Luego descubrimos que todo el mundo sigue pegando cosas, desde cuentas personales, en el móvil, fuera de horario". Esto es el shadow AI: el uso de servicios LLM públicos con datos sensibles, fuera del control del departamento de TI, normalmente con la mejor intención. Es el principal riesgo de la IA dentro de los despachos profesionales en 2026.
El shadow AI vulnera el RGPD de tres formas específicas. Primera, el proveedor LLM se convierte en encargado del tratamiento sin Acuerdo de Tratamiento de Datos. El art. 28 requiere un DPA — el art. 28.3 lista las ocho cláusulas mínimas — antes de cualquier tratamiento por cuenta del responsable. Un usuario que pega nombres de clientes en una cuenta ChatGPT personal crea tratamiento sin DPA, sin registro de actividades de tratamiento (art. 30), sin la verificación que exige el art. 28 y sin una cadena de subencargados documentada. Usar ChatGPT conforme al RGPD solo es sostenible con la versión empresarial y un contrato firmado. Segunda, con la configuración por defecto de la versión de consumo, la entrada puede usarse para entrenar el siguiente modelo, creando una divulgación irreversible que el derecho de supresión (art. 17) no puede deshacer. Tercera, las transferencias cruzan la frontera UE hacia un centro de datos de EE. UU. sin que el responsable haya realizado una evaluación de impacto de la transferencia tras Schrems II. Con la configuración de consumo, la privacidad de ChatGPT no supera la prueba; las versiones empresariales sí, pero para ser defendibles exigen diligencia en la contratación y un paso previo de ocultación.
La detección y la censura de documentos de Redactic se ejecutan en infraestructura controlada por Redactic en Europa, sin inferencia de IA o aprendizaje automático de terceros sobre contenido sin censurar. Los flujos opcionales de IA son independientes: los valores sensibles detectados se eliminan o sustituyen antes de enviar el contenido preparado al proveedor elegido. Revisa el texto del documento, las instrucciones adicionales y los mensajes de chat; los valores omitidos y los detalles contextuales aún pueden identificar a personas. El proveedor, la región y las condiciones de conservación y entrenamiento dependen del flujo seleccionado y del acuerdo aplicable.
No es una preocupación teórica. Samsung prohibió ChatGPT y otras herramientas de IA generativa en mayo de 2023 después de que, según se informó, empleados introdujeran en el chatbot información de la empresa, incluido código fuente. La Garante italiana suspendió temporalmente ChatGPT el 30 de marzo de 2023 sobre el art. 6 (base jurídica), art. 13 (informativa) y la falta de verificación de edad; el servicio se restableció el 28 de abril de 2023 solo después de que OpenAI implementara un age gate, un opt-out y una informativa explícita. La Garante emitió decisión final el 20 de diciembre de 2024 con sanción de 15 millones de euros. En paralelo, la AEPD española abrió investigación en abril de 2023, y el EDPB formó una task force dedicada a ChatGPT en abril de 2023 que publicó sus hallazgos preliminares en mayo de 2024. El estudio Cyberhaven 2023 encontró que el 11 % de los prompts ChatGPT corporativos contenían datos sensibles — registros de nómina, código fuente, información de clientes — subidos desde dentro de los firewalls. El AI Act UE añade obligaciones sobre GPAI desde agosto de 2025 que constriñen aún más cómo pueden usarse los servicios LLM de consumo en contextos regulados. Para adoptar la IA, tu despacho necesita antes una política de privacidad definida para su uso.
Un flujo de IA aprobado debería ser práctico para el personal y contar con reglas claras de tratamiento. Redactic ofrece flujos opcionales de IA junto con la censura documental, con enmascaramiento de los valores sensibles detectados. Aquí no se afirma ninguna ventaja comparativa de velocidad: el tiempo de procesamiento y el esfuerzo de revisión dependen del archivo, la tarea y el flujo.
Al dimensionar el riesgo de shadow AI en su propio despacho, conviene tratar con cautela las estadísticas que circulan: nuestra auditoría de las estadísticas de shadow AI más repetidas rastrea cada cifra hasta su fuente primaria y muestra varias que no miden lo que suele atribuírseles.
Para usar la IA sin entregar nombres ni identificadores, Redactic permite preparar documentos para la IA: los valores detectados se convierten en marcadores y los nombres reales se restauran en el navegador cuando llega la respuesta.
7. Elegir una herramienta de ocultación: 8 puntos de evaluación
Si estás comprando una herramienta o evaluando un desarrollo interno frente a un producto del mercado, la siguiente lista de comprobación es la que usamos con clientes potenciales. Puntúa cada punto de 0 a 2 (no / parcial / sí) y pondera por el doble los puntos relativos a la privacidad. Si terminas por debajo de 18 sobre 32 posibles, tienes un riesgo de cumplimiento; por debajo de 12, también un riesgo de productividad.
- Arquitectura no-trace. ¿Procesa el servicio el documento en memoria y lo descarta de inmediato? ¿Las entradas están cifradas en reposo en el almacén efímero, con TTL corto, y nunca se escriben en un registro persistente? Por qué importa: una copia conservada sigue siendo dato personal — el propio proceso de ocultación se convierte en una actividad de tratamiento separada si el input sobrevive a la petición.
- Detección PII multilingüe. ¿Maneja el modelo DNI/NIE español, NIR francés, Codice Fiscale italiano, Steuer-ID alemán, PESEL polaco, etc., o solo nombres en inglés y SSN de EE. UU.? Por qué importa: los detectores anglocéntricos pierden el 30-50 % de los identificadores nacionales en documentos UE.
- OCR para escaneos. ¿Puede la herramienta ocultar los datos de un PDF escaneado o una foto de DNI con ennegrecimiento pixel-perfect? Por qué importa: los casos que más asustan a tu DPO — contratos antiguos, documentos fotografiados — son justo los que una herramienta solo de texto no resuelve.
- Soporte de dos modos. ¿Puede la herramienta producir salidas reversibles (marcador) e irreversibles (ennegrecimiento) desde la misma carga? Por qué importa: las herramientas de un solo modo obligan a mantener dos procesos.
- Revisión manual. ¿Permite la interfaz a una persona aceptar o rechazar cada fragmento detectado antes de aplicar la ocultación? Por qué importa: una detección orientada a la exhaustividad es la opción correcta por defecto, pero produce falsos positivos que necesitan una revisión rápida.
- Limpieza de metadatos. ¿Retira la herramienta también las propiedades del documento (autor, last-modified-by, XMP, EXIF)? Por qué importa: la fuga más común en producción es un cuerpo limpio con un nombre de autor en las propiedades del PDF.
- Certificado de auditoría. ¿Genera la herramienta un registro criptográfico por trabajo de lo procesado, con hashes y conteos por categoría pero sin contenido? Por qué importa: el certificado es lo que muestras a la autoridad de control, al asegurador, al cliente.
- Postura de cumplimiento. Residencia de datos en la UE, DPA incluido en el alta, registro de subencargados, consentimiento click-wrap con snapshot criptográfico, separación de roles (tu herramienta como encargado, no responsable). Por qué importa: son los puntos que determinan si la herramienta encaja en tu programa RGPD existente o crea nuevas actividades de tratamiento que ahora hay que gobernar.
Las herramientas que llegan como extensión Chrome pueden ser elegantes pero puntúan mal en (1) y (8) — pocas veces hay un DPA real detrás de una extensión gratuita. Las librerías open source como Presidio o Piiranha puntúan bien en (2) pero heredas la huella operativa (no-trace, OCR, auditoría, certificado) que es la mayor parte del trabajo. Las herramientas comerciales alojadas varían; la pregunta útil para el proveedor es "muéstrame el certificado de un trabajo de muestra y la lista de subencargados".
La decisión entre desarrollo interno y compra debe tener en cuenta la gestión documental, la revisión humana, la validación de los resultados, los controles de conservación, la gestión de accesos, la documentación contractual y el soporte continuado. Un prototipo de detección es solo una parte de un servicio mantenido en el tiempo. Compara el esfuerzo operativo total con los requisitos de tu organización utilizando documentos representativos.
Redactic combina detección automática, procesamiento documental y revisión humana para ayudar a identificar información sensible, también en los documentos escaneados compatibles. Revisa los valores detectados antes de aplicar censura permanente o enmascaramiento reversible. La cobertura depende de la calidad del documento, el idioma y el contexto; la automatización puede pasar por alto información. Evalúa archivos representativos y resultados exportados antes de adoptar un flujo. Más información: DPA
Limitaciones importantes: el formato de exportación y la conservación de la maquetación dependen del flujo elegido. Los escaneos, los nombres parciales, las grafías alternativas y los identificadores contextuales pueden producir detecciones omitidas o incoherentes. Revisa estos casos y el archivo exportado final. La restauración reversible puede necesitar una tabla de correspondencias que debe protegerse por separado.
8. Preguntas frecuentes
¿Cuál es la diferencia entre ocultación de datos y anonimización?
La censura elimina información seleccionada de un resultado. El enmascaramiento reversible sustituye los valores detectados y utiliza una tabla de correspondencias para restaurarlos. La censura permanente no convierte automáticamente en anónimo el documento restante: la información contextual aún puede identificar a personas. Evalúa la identificabilidad por separado antes de tratar un resultado como anónimo.
¿La pseudonimización es lo mismo que el cifrado?
No. El cifrado es reversible para cualquiera con la clave y es un control de seguridad; la pseudonimización sustituye valores identificativos con marcadores y mantiene la correspondencia de retorno bajo control de acceso más estricto. El RGPD reconoce explícitamente la pseudonimización en el art. 4(5) y art. 32(1)(a); los datos personales cifrados siguen siendo datos personales.
¿Puedo usar ChatGPT con documentos cuyos datos se han ocultado sin incumplir el RGPD?
La censura puede ayudar a reducir la información personal compartida con un proveedor de IA, pero no convierte automáticamente un uso en lícito. Revisa el contenido preparado, incluidas las instrucciones adicionales, confirma las condiciones del proveedor y evalúa la finalidad, la base jurídica y el contexto restante. En el SaaS de Redactic, los documentos se cargan en Redactic para procesarlos antes de cualquier tarea opcional de IA seleccionada por separado.
¿Funciona la detección automática de datos personales en PDF escaneados?
El OCR puede ayudar a detectar texto en PDF escaneados e imágenes. Redactic admite flujos documentales con escaneos dentro de los formatos e idiomas compatibles. Revisa las páginas de baja calidad y los resultados exportados; el OCR y la detección automática pueden pasar por alto información sensible.
¿Cuánto tiempo debe conservarse la tabla de correspondencias?
Conserva una tabla de restauración solo durante el tiempo y para la finalidad que requiera tu flujo, y protege su acceso. Consulta el acuerdo aplicable para conocer las condiciones de procesamiento temporal y eliminación de Redactic. Cualquier tabla que descargues o conserves por tu cuenta necesita sus propias reglas de gestión y conservación.
¿Qué es el shadow AI y por qué es un problema para el RGPD?
El shadow AI es el uso de servicios LLM públicos con datos sensibles, fuera del control del departamento de TI, normalmente mediante cuentas personales. Crea tratamiento sin DPA (art. 28), transferencias internacionales no documentadas (Schrems II) y posible uso de la entrada para entrenamiento. La mitigación eficaz es un camino oficial más rápido y seguro que el uso no autorizado, porque las prohibiciones siempre se bordean.
¿El AI Act cambia algo sobre la ocultación?
Sí. Los sistemas IA de alto riesgo bajo el Anexo III (RR. HH., selección, evaluación del desempeño) deben cumplir obligaciones de gobernanza de datos (art. 10), gestión de riesgos (art. 9), supervisión humana (art. 14). Pseudonimizar los datos de entrada antes de dárselos a tal sistema es la forma más limpia de satisfacer simultáneamente la minimización bajo art. 5 RGPD y el art. 10 AI Act. El AI Act no exige explícitamente la ocultación pero la premia operativamente.
¿Qué es un certificado de ocultación y por qué lo necesito?
Un certificado de censura puede complementar tus registros de operaciones con hashes de documentos y resúmenes de las eliminaciones. No demuestra que se haya detectado cada valor sensible, no acredita la anonimización ni prueba por sí solo que no se haya conservado ninguna copia del documento. Comprueba los campos reales del certificado frente a tus requisitos de auditoría.
¿Puedo ocultar los datos de una hoja de Excel con datos de empleados sin romper las fórmulas?
Redactic admite flujos de censura de hojas de cálculo. Prueba un libro representativo y comprueba las hojas exportadas, las fórmulas, los valores numéricos, la maquetación y las propiedades. No supongas que se conserva cada función de la hoja de cálculo o que se ha detectado toda la información sensible.
¿Dónde almacena Redactic mis datos?
Los documentos y resultados utilizan almacenamiento temporal de procesamiento en infraestructura controlada por Redactic en Europa. Los datos de restauración pueden implicar procesamiento temporal en el servidor. Los datos de cuenta, facturación, consentimiento y los registros de operaciones se gestionan por separado. Consulta el DPA y el aviso de privacidad de Redactic para conocer las condiciones de conservación y eliminación, y pídenos que confirmemos el perfil aplicable a tu flujo. Más información: páginas trust
Si lees solo una cosa de esta guía, lee la sección 6 sobre shadow AI. El mayor riesgo individual en tu despacho en 2026 no es una ocultación manual mal hecha; es el efecto acumulado de mil pequeños copia-y-pega en ChatGPT desde cuentas personales. La respuesta es un camino oficial más rápido, con ocultación correcta y un DPA firmado, porque las reglas más estrictas se bordearán. Construye el camino antes de que el regulador lo construya por ti.
Si quieres ver cómo funciona en la práctica, la página principal de Redactic recorre los cuatro modos de uso (Enmascarar, Anonimizar, Usar con IA, Chatbot seguro) con una demo en vivo sobre un contrato de ejemplo. El plan Solo cubre a un profesional individual a 19 €/mes; el plan Firm añade el chat IA seguro y hasta cincuenta puestos a 49 €/mes; Enterprise es a medida. El DPA se firma al darse de alta y el certificado de ocultación puede descargarse desde cada trabajo completado.