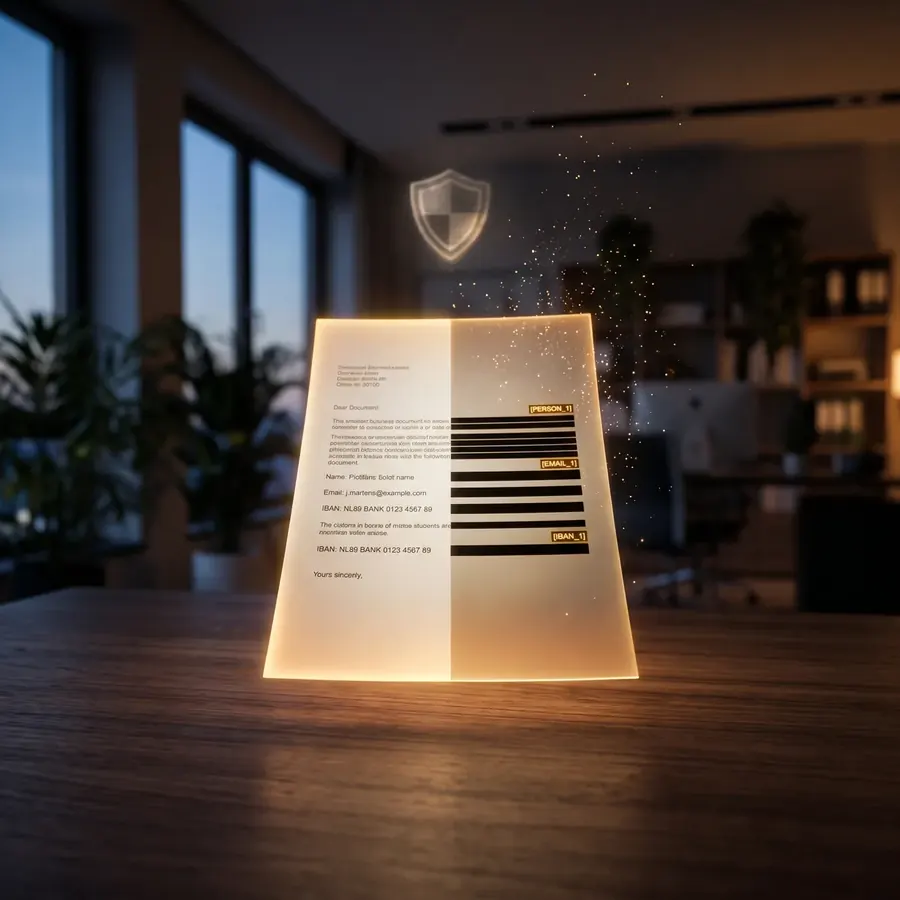
Loonstroken, contracten, gespreksnotities en klantcorrespondentie kunnen gevoelige informatie bevatten. Documentmaskering helpt geselecteerde informatie te verwijderen uit de versie die u wilt delen of verwerken. Omkeerbaar maskeren en permanent maskeren dienen verschillende doelen; geen van beide stelt automatisch vast dat een resultaat anoniem is of dat een vervolggebruik rechtmatig is.
Deze gids is het uitgebreide naslagwerk dat wij misten toen we Redactic bouwden. Hij behandelt wat gegevensmaskering werkelijk is en wat niet, hoe de AVG het kader schetst (pseudonimisering volgens artikel 4 tegenover anonimisering volgens overweging 26), de twee maskeermodi die u in de praktijk gebruikt, de categorieën persoonsgegevens die vóór elk AI-gebruik gemaskeerd moeten worden, een werkwijze in vijf stappen die meegroeit van één pdf tot een salarisspreadsheet met meerdere bladen, het werkelijke AVG-risico van shadow AI binnen professionele dienstverleners, een checklist van acht punten voor de keuze van een maskeertool en een FAQ met de vragen die klanten ons wekelijks stellen.
U kunt het hele artikel van begin tot eind lezen, het is geschreven om vluchtig door te kunnen lopen, of direct naar het onderdeel springen dat bij uw acute probleem past. Heeft uw kantoor het gesprek over ChatGPT al gevoerd en verloren, begin dan bij het onderdeel over shadow AI. Maakt u zich vooral zorgen over inspecties van de toezichthouder, begin dan bij het AVG-kader.
1. Wat gegevensmaskering is en wat niet
Gegevensmaskering (in het Engels redaction) is het proces waarbij persoonsgegevens of andere gevoelige informatie in een document worden herkend en verwijderd uit de versie die verder wordt gedeeld, verwerkt of opgeslagen. De term komt uit de juridische praktijk, waar passages in processtukken werden zwartgemaakt vóór publicatie; in digitale workflows omvat hij veel meer handelingen, van een naam vervangen door een plaatshouder tot een gebied in een afbeelding pixelperfect onherstelbaar zwart maken.
Mensen gebruiken “maskeren”, “anonimiseren”, “pseudonimiseren”, “afschermen”, “versleutelen” en “verwijderen” vaak door elkaar. Ze zijn niet uitwisselbaar en het verschil is onder de AVG van belang. We komen op de juridische nuances terug in onderdeel 2; onthoud voorlopig de volgende onderscheidingen.
- Maskeren (redaction) is de overkoepelende handeling: een document met persoonsgegevens omzetten in een versie die die gegevens niet meer bevat (of niet meer op een manier die aanvallers of onbevoegde lezers kunnen herstellen).
- Afschermen (masking), ook wel gegevensmaskering genoemd, is één techniek: elk gedetecteerd stuk persoonsgegevens vervangen door een plaatshouder zoals
[PERSON_1]of⟦NAME⟧. De plaatshouder is betekenisvol voor een volgend proces (bijvoorbeeld een LLM), maar bevat zelf geen identificator. In de praktijk kiest u bij het maskeren van persoonsgegevens tussen dit pad en een permanente zwartmaking, afhankelijk van waar het document naartoe gaat. - Pseudonimisering is afschermen plus een gecontroleerde, apart bewaarde koppeling terug naar de oorspronkelijke waarden. De AVG erkent dit uitdrukkelijk in artikel 4, punt 5, en beloont het in de hele tekst, maar het maakt de gegevens niet “anoniem”.
- Anonimisering is eenrichtingsverkeer en onomkeerbaar. Na anonimisering mag niemand, ook u niet, de betrokkene nog kunnen heridentificeren. De AVG legt die lat in overweging 26, en anonieme gegevens vallen helemaal buiten de verordening.
- Versleuteling is omkeerbaar voor iedereen met de sleutel. Versleutelde persoonsgegevens blijven persoonsgegevens onder de AVG; versleuteling is een beveiligingsmaatregel en geen maskeertechniek.
- Verwijdering haalt het document weg; maskeren haalt de persoonsgegevens uit een document dat u houdt.
Kies permanent maskeren wanneer geselecteerde gevoelige informatie uit het gedeelde resultaat moet verdwijnen. Kies omkeerbaar maskeren wanneer een ondersteunde workflow plaatshouders en latere herstelling nodig heeft. Beoordeel in beide gevallen de resterende context en indirecte identificatoren. Permanent maskeren stelt anonimisering niet automatisch vast.
Een tweede veelvoorkomend patroon is dat maskeren wordt behandeld als eenmalige stap vóór het delen. In een kantoor met gedeelde schijven, wekelijks LLM-gebruik en uitbestede verwerkers moet maskeren onderdeel zijn van de workflow, bij het uploaden, op het moment van het AI-verzoek en bij het exporteren. Een maandelijkse handmatige controle door een paralegal met een zwarte markeerstift volstaat daarvoor niet.
2. Het AVG-kader: pseudonimisering volgens art. 4, punt 5, tegenover anonimisering volgens overweging 26
Drie verwijzingen naar de AVG bepalen elk serieus gesprek over gegevensmaskering in de EU.
Artikel 4, punt 5, AVG definieert pseudonimisering als “het verwerken van persoonsgegevens op zodanige wijze dat de persoonsgegevens niet meer aan een specifieke betrokkene kunnen worden gekoppeld zonder dat er aanvullende gegevens worden gebruikt”. Die aanvullende gegevens moeten “apart worden bewaard en technische en organisatorische maatregelen worden genomen om ervoor te zorgen dat de persoonsgegevens niet aan een geïdentificeerde of identificeerbare natuurlijke persoon worden gekoppeld”. Gepseudonimiseerde gegevens blijven persoonsgegevens: de AVG blijft gelden, u hebt nog steeds een rechtsgrond nodig en de betrokkene houdt zijn rechten op inzage en wissing.
Overweging 26 AVG trekt de grens voor anonimisering: “De beginselen van gegevensbescherming dienen derhalve niet van toepassing te zijn op anonieme gegevens, namelijk gegevens die geen betrekking hebben op een geïdentificeerde of identificeerbare natuurlijke persoon of persoonsgegevens die zodanig anoniem zijn gemaakt dat de betrokkene niet of niet meer identificeerbaar is.” Anonieme gegevens vallen buiten het toepassingsgebied. De lat ligt hoog en is het best te begrijpen aan de hand van de drie criteria uit Advies 05/2014 van de Groep gegevensbescherming artikel 29: uitlichten, koppelbaarheid en inferentie. Als een gemaskeerd document nog steeds toelaat om één persoon uit te lichten, records over datasets heen te koppelen of eigenschappen van een bepaalde persoon af te leiden, dan hebt u gepseudonimiseerd en niet geanonimiseerd.
Artikel 25 (gegevensbescherming door ontwerp en door standaardinstellingen) en artikel 32 (beveiliging van de verwerking) wijzen samen pseudonimisering aan als verstandige technische maatregel bij risicovolle verwerking. Artikel 32, lid 1, onder a, noemt het uitdrukkelijk. Daarom wordt een AVG-programma dat in goede pseudonimisering heeft geïnvesteerd door toezichthouders gunstig beoordeeld: het is een maatregel die de verordening zelf bij naam noemt.
De EU-verordening kunstmatige intelligentie, die op dit terrein met de AVG overlapt, is sinds 2024 van kracht, met bepalingen voor hoog-risicosystemen die in 2026 en 2027 gefaseerd ingaan, en voegt nog een laag toe. AI-systemen voor hr (werving, functioneringsbeoordeling, promotiebeslissingen) vallen onder bijlage III in de categorie hoog risico. Ze vereisen risicobeheer, datagovernance, technische documentatie, transparantie, menselijk toezicht, maatregelen voor nauwkeurigheid, robuustheid en cyberbeveiliging en een beoordeling van de gevolgen voor de grondrechten. De verordening verplicht niet tot pseudonimisering vóór AI-gebruik, maar in de praktijk is dat de zuiverste manier om tegelijk aan gegevensminimalisatie (art. 5 AVG) en het datagovernance-artikel van de AI-verordening (art. 10) te voldoen. Voor AI-gebruik werken AVG en AI-verordening het best als één bedrijfsmodel waarin de twee regelingen samen worden aangepakt.
Eén mythe moet worden doorgeprikt: veel aanbieders presenteren hun tool als “AVG-anonimisering” terwijl het pseudonimisering is. Als de koppeling van plaatshouder naar oorspronkelijke waarde ergens bestaat, op uw bestandssysteem, in de browser van de gebruiker of in een dienst die wij beheren, zijn de gegevens gepseudonimiseerd en niet anoniem. Pseudonimisering onder de AVG is een nuttige waarborg en het is niet verkeerd die aan te bieden; het anonimisering noemen misleidt en brengt de klant in een nalevingsval. Het maskeringscertificaat van Redactic maakt het onderscheid uitdrukkelijk en markeert elke omkeerbare taak als pseudonimisering volgens artikel 4, punt 5.
De rechtspraak heeft de grens verder aangescherpt. In Breyer tegen Duitsland (C-582/14, 2016) oordeelde het Hof van Justitie dat een IP-adres dat een websiteaanbieder bewaart een persoonsgegeven is, als de aanbieder redelijke wettelijke middelen heeft om de aanvullende identificerende gegevens van een derde te verkrijgen. De toets van “redelijke middelen” is ruimer dan veel ingenieurs veronderstellen: gegevens die uw dienst alleen niet kan identificeren, kunnen toch persoonsgegevens zijn als een gerechtelijk bevel of een contractuele regeling de ontbrekende stukken kan leveren. Voor maskeren betekent dit dat een splitsing in plaatshouder en koppeling over twee organisaties niet automatisch anonimisering is: als een van beide partijen de ander rechtmatig kan dwingen de koppeling bekend te maken, zijn de gegevens voor beide gepseudonimiseerd. Het arrest SRB tegen EDPS uit 2023 (T-557/20) versterkte het contextuele karakter van de toets door gepseudonimiseerde gegevens bij een ontvanger die niet kan heridentificeren te onderscheiden van dezelfde gegevens bij de verwerkingsverantwoordelijke die dat wel kan.
Advies 05/2014 van de Groep gegevensbescherming artikel 29 (inmiddels onderschreven door de EDPB) maakt overweging 26 uitvoerbaar met drie concrete aanvalsmodellen. Uitlichten: kan een aanvaller één record isoleren dat bij één persoon hoort? Koppelbaarheid: kunnen twee records uit dezelfde dataset, of uit verschillende datasets, aan dezelfde persoon worden gekoppeld? Inferentie: kan de waarde van een kenmerk worden afgeleid uit een combinatie van de andere? Als het antwoord op een van de drie ja is, is het document gepseudonimiseerd en niet geanonimiseerd. De praktische les is dat het maskeren van de naam op een salarisspreadsheet die niet anoniem maakt, omdat de rij nog steeds één werknemer uitlicht, en dat het werkelijk anonieme geval zeldzamer is dan aanbieders suggereren.
3. De twee maskeermodi: omkeerbaar (plaatshouderkoppeling) en onomkeerbaar (zwartmaking)
In de praktijk gebruikt u voortdurend twee modi. Het verschil begrijpen is het verschil tussen een workflow die een inspectie overleeft en een die namen lekt omdat u het verkeerde gereedschap voor de klus koos.
Omkeerbaar maskeren vervangt gedetecteerde gevoelige waarden door plaatshouders en gebruikt in ondersteunde workflows een aparte koppeling voor herstel. Bescherm de koppeling en controleer de voorbereide tekst vóór elke optionele AI-taak. Gemiste waarden en contextuele informatie kunnen personen nog steeds identificeren.
Herstelkoppelingen vragen om bescherming en een vast bewaarbeleid. Afhankelijk van de workflow kan de verwerking naast lokaal herstel ook tijdelijke toestand aan de serverkant omvatten. Redactic beweert niet dat de oorspronkelijke inhoud of de koppelingsgegevens altijd in de browser blijven. Raadpleeg de toepasselijke DPA voor de verplichtingen rond bewaren en verwijderen.
Permanent maskeren verwijdert geselecteerde gevoelige informatie uit het geëxporteerde document. Bij scans en afbeeldingen kan OCR helpen de tekst te vinden die moet worden nagekeken. Controleer het resultaat op gemiste waarden, verborgen informatie en indirecte identificatoren. Het vernietigen van geselecteerde tekst of beeldgebieden toont op zichzelf niet aan dat personen aan de hand van de resterende inhoud niet meer kunnen worden geïdentificeerd.
De fout die we het vaakst zien, is de omgekeerde: een kantoor voert een “anonimiseringsronde” uit die in feite omkeerbaar maskeren is, deelt het bestand extern en laat de koppeling op een gedeelde schijf staan waar de ontvanger uiteindelijk bij kan. Het resultaat is een heridentificeerbaar record op de server van een derde. Kies de modus op basis van de bestemming van het document.
Redactic biedt omkeerbaar en permanent maskeren voor ondersteunde workflows. Beschikbare exportformaten en behoud van de opmaak hangen af van de invoer en de gekozen bewerking. Bevestig het resultaat met een representatief bestand; ga er niet van uit dat omkeerbaar maskeren een pdf in het oorspronkelijke formaat behoudt.
4. Categorieën persoonsgegevens die vóór AI-gebruik gemaskeerd moeten worden
Niet elk persoonsgegeven weegt even zwaar in de regelgeving. De AVG onderscheidt “persoonsgegevens” (art. 4, punt 1), alles wat een natuurlijke persoon identificeert of kan identificeren, van “bijzondere categorieën” (art. 9) zoals gezondheidsgegevens, biometrische identificatoren, ras of etnische afkomst, politieke opvattingen, religieuze overtuigingen, lidmaatschap van een vakbond, seksuele geaardheid en genetische gegevens. Voor bijzondere categorieën ligt de lat voor verwerking aanzienlijk hoger (uitdrukkelijke toestemming, vitale belangen, algemeen belang op het gebied van gezondheid enzovoort) en is het risico op onbedoelde openbaarmaking aan de LLM-kant navenant groter.
De volgende tabel is de praktische shortlist die wij gebruiken. Voordat een document naar ChatGPT, Claude, Gemini, Mistral of een andere LLM-aanbieder gaat, moet elk item hieronder worden gemaskeerd met een plaatshouder of zwartgemaakt, afhankelijk van of de workflow omkeerbaarheid nodig heeft.
| Categorie | Voorbeelden | Waarom het ertoe doet |
|---|---|---|
| Directe identificatoren | Volledige naam, e-mailadres, telefoonnummer, postadres | De minimale set persoonsgegevens; direct heridentificerend. |
| Nationale identificatoren | Italiaanse Codice Fiscale, Franse NIR/INSEE, Duitse Steuer-ID, Spaanse DNI/NIE, EU-paspoortnummers | Landspecifieke identificatoren vragen om passende dekking en controle door een mens. Een overeenkomend formaat bevestigt niet dat het nummer geldig is of van wie het is. |
| Financieel | IBAN, SWIFT, betaalkaartnummers, bankrekening, belasting-/btw-nummer | Risico dat aansluit bij PCI-DSS en direct fraude-risico. |
| Dienstverband | Personeelsnummer, loonregel, datum indiensttreding, salaris, beoordeling | Maakt identificatie in een kleine organisatie ook zonder naam mogelijk. |
| Gezondheid (art. 9) | Diagnoses, medicatie, redenen van ziekteverzuim, aantekeningen van de bedrijfsarts | Bijzondere categorie; uitdrukkelijke toestemming of een andere grondslag uit art. 9 vereist. |
| Biometrie / identiteitsdocumenten | Nummers van identiteitskaarten, rijbewijzen, paspoorten, gezichtsfoto's | Bijzondere categorie als gebruikt voor unieke identificatie. |
| Quasi-identificatoren | Geboortedatum + postcode + geslacht, exacte functie + afdeling, zeldzame functietitel | Gebruikt bij koppelingsaanvallen. De 87%-regel van Sweeney: postcode + geboortedatum + geslacht identificeert de meeste Amerikaanse volwassenen. |
| Onthullingen in vrije tekst | Uitdiensttredingsgesprekken, klantklachten, supporttickets | De lastigste categorie. Ontsnapt vaak aan patroongebaseerde maskeertools en vraagt om ML-gebaseerde herkenning van entiteiten. |
Automatische detectie van persoonsgegevens kan patroongebaseerde en machinelerende technieken combineren om waarschijnlijk gevoelige informatie te vinden. Redactic combineert automatische detectie met documentverwerking en controle door mensen op infrastructuur in Europa die Redactic beheert. Niet-gemaskeerde inhoud wordt tijdens detectie of maskering niet naar AI- of machinelearningdiensten van derden gestuurd. De nauwkeurigheid hangt af van documentkwaliteit, taal en context.
OCR maakt tekst in ondersteunde scans en afbeeldingen beschikbaar voor detectie en controle. Lage resolutie, rotatie, handschrift en complexe opmaak kunnen het resultaat beïnvloeden. Controleer elke relevante pagina en het geëxporteerde document; OCR-ondersteuning garandeert niet dat elke gevoelige waarde wordt gevonden.
Rapporten die grotendeels uit gezondheidsinformatie bestaan, vragen om dezelfde zorg, en Redactic laat zien hoe psychologen psychologische rapporten en rapporten van deskundigen kunnen maskeren voordat ze die delen met advocaten, scholen of de rechtbank.
5. De werkwijze in vijf stappen die meegroeit
Een herhaalbare maskeerwerkwijze combineert documentselectie, automatische detectie, controle door een mens, toepassing en verificatie van het resultaat. De volgende vijf stappen zijn een praktisch vertrekpunt; pas ze aan op de eisen voor gegevensverwerking en goedkeuring binnen uw organisatie.
- Uploaden. Kies een ondersteund document en bevestig dat u het mag verwerken. In standaard SaaS wordt het originele document geüpload naar Redactic voor verwerking in Europa. Detectie en maskering sturen geen niet-gemaskeerde inhoud naar AI-diensten van derden.
- Detecteren. Herken waarschijnlijke namen, contactgegevens, financiële gegevens en relevante nationale identificatoren. Bij scans en afbeeldingen kan tekstherkenning helpen informatie te vinden. Behandel detecties als suggesties die gecontroleerd moeten worden.
- Controleren. Bekijk de gedetecteerde waarden, corrigeer valse positieven en zoek naar gevoelige informatie die is gemist. Let vooral op contextuele identificatoren, scans van slechte kwaliteit, tabellen en afwijkende spellingen.
- Toepassen. Kies permanent of omkeerbaar maskeren voor de beoogde bestemming. Bescherm herstelkoppelingen wanneer u ze gebruikt. Controleer naast de zichtbare tekst ook de documenteigenschappen en verborgen informatie; formaatspecifieke beperkingen zijn van belang.
- Delen of herstellen. Controleer het geëxporteerde resultaat voordat u het deelt. Kiest u een optionele AI-workflow, bekijk dan eerst de voorbereide inhoud en de voorwaarden van de aanbieder. Herstel waarden alleen in een ondersteunde workflow met een afdoende beschermde koppeling. Bewaar registraties van bewerkingen die passen bij uw auditvereisten.
Een maskeringscertificaat kan uw registratie van bewerkingen aanvullen met documenthashes en samenvattingen van het maskeren. Het bewijst niet dat elke gevoelige waarde is gedetecteerd, stelt geen anonimisering vast en bewijst niet onafhankelijk dat geen kopie van een document is bewaard. Leg de velden van het daadwerkelijke certificaat naast uw auditvereisten.
Een salaristeam kan bijvoorbeeld een spreadsheet met meerdere bladen nakijken op namen van werknemers, fiscale identificatoren, bankgegevens en gevoelige aantekeningen. Bevestig de detecties, corrigeer gemiste waarden en kies omkeerbaar of permanent maskeren, al naargelang. Controleer de geëxporteerde werkmap, inclusief formules, numerieke cellen, verborgen bladen, opmerkingen en eigenschappen, voordat u die deelt. Dit voorbeeld illustreert een werkwijze en is geen gemeten garantie voor nauwkeurigheid of verwerkingstijd.
6. Shadow AI: waarom onbezonnen ChatGPT-gebruik de AVG schendt
Het gesprek dat we het vaakst met klanten voeren, begint zo: “We hebben ChatGPT voor gevoelige gegevens verboden. Toen ontdekten we dat iedereen toch dingen plakt, vanaf persoonlijke accounts, op telefoons, na werktijd.” Dat is shadow AI: het gebruik van openbare LLM-diensten met gevoelige gegevens, zonder zicht van IT, vaak met de beste bedoelingen. In 2026 is het het dominante AI-risico bij professionele dienstverleners.
Shadow AI schendt de AVG op drie specifieke manieren. Ten eerste wordt de LLM-aanbieder verwerker zonder verwerkersovereenkomst. Artikel 28 vereist zo'n overeenkomst, artikel 28, lid 3, somt de acht bepalingen op die erin moeten staan, vóór elke verwerking namens de verwerkingsverantwoordelijke. Een gebruiker die klantnamen in een persoonlijk ChatGPT-account plakt, creëert verwerking zonder overeenkomst, zonder vermelding in het register van verwerkingsactiviteiten (art. 30), zonder toetsing volgens artikel 28 en zonder gedocumenteerde keten van subverwerkers. Ten tweede kan, afhankelijk van de standaardinstellingen van de aanbieder in de consumentenversie, de invoer worden gebruikt om het volgende model te trainen, een onomkeerbare openbaarmaking die wissing (art. 17) niet ongedaan kan maken. Ten derde gaan de gegevens over de EU-grens naar een Amerikaans datacenter zonder dat de verwerkingsverantwoordelijke na Schrems II een beoordeling van de gevolgen van de doorgifte heeft uitgevoerd.
Detectie en maskering van documenten in Redactic draaien op infrastructuur in Europa die Redactic beheert, zonder AI- of machinelearninginferentie van derden op niet-gemaskeerde inhoud. Optionele AI-workflows staan los daarvan: gedetecteerde gevoelige waarden worden verwijderd of vervangen voordat de voorbereide inhoud naar de gekozen aanbieder gaat. Controleer de documenttekst, aanvullende instructies en chatberichten; gemiste waarden en contextuele details kunnen personen nog steeds identificeren. Aanbieder, regio, bewaartermijn en trainingsvoorwaarden hangen af van de gekozen workflow en de toepasselijke overeenkomst.
Dit is geen theoretische zorg. Samsung verbood ChatGPT en andere generatieve AI-tools in mei 2023 nadat medewerkers naar verluidt bedrijfsinformatie, waaronder broncode, in de chatbot hadden ingevoerd. De Italiaanse Garante schorste ChatGPT tijdelijk op 30 maart 2023 wegens art. 6 (rechtsgrond), art. 13 (informatieplicht) en het ontbreken van leeftijdsverificatie; de dienst werd pas op 28 april 2023 hersteld nadat OpenAI een leeftijdscontrole, een opt-out en een expliciete informatieverstrekking had ingevoerd. De Garante nam vervolgens op 20 december 2024 een definitief besluit met een boete van 15 miljoen euro. Tegelijk opende de Spaanse AEPD in april 2023 een onderzoek, en de Europese Raad voor gegevensbescherming (EDPB) vormde in april 2023 een speciale ChatGPT-taskforce die in mei 2024 haar voorlopige bevindingen publiceerde. Uit de Cyberhaven-studie van 2023, aangehaald door Cleansum, bleek dat 11% van de zakelijke ChatGPT-prompts gevoelige gegevens bevatte, zoals salarisgegevens, broncode en klantinformatie, vanuit de bedrijfsfirewall geüpload. De AI-verordening voegt vanaf augustus 2025 verplichtingen voor AI voor algemene doeleinden toe die het gebruik van consumenten-LLM-diensten in gereguleerde contexten verder beperken. Een geloofwaardig antwoord op privacy rond ChatGPT is nu de operationele voorwaarde voor AI-adoptie binnen uw kantoor.
Een goedgekeurde AI-workflow moet praktisch zijn voor medewerkers en ondersteund worden door duidelijke omgangsregels. Redactic biedt optionele AI-workflows naast documentmaskering, met afscherming van gedetecteerde gevoelige waarden. We doen hier geen vergelijkende beweringen over snelheid: verwerkingstijd en controle-inspanning hangen af van het bestand, de taak en de workflow.
Als inkoopvraag komt gegevensprivacy bij LLM's neer op drie concrete antwoorden. (1) Heeft de aanbieder een EU-endpoint met gegevensverblijf in de EU en een duidelijke lijst van subverwerkers? (2) Is uw invoer standaard uitgesloten van modeltraining, met een ondertekende verwerkersovereenkomst daarover? (3) Is de bewaartermijn nul of strikt begrensd, met een auditspoor dat u kunt reproduceren? Alles wat zwakker is dan ja op alle drie legt de last van de naleving terug bij uw kantoor, en bij de advocaat, accountant of hr-verantwoordelijke die daar noch tijd noch opleiding voor heeft. De standaardinstellingen voor privacy van de consumentenversie van ChatGPT doorstaan deze toets niet; de zakelijke versies doen dat wel, maar vragen zowel zorgvuldige inkoop als een maskeerlaag ervoor om verdedigbaar te zijn.
Bij het inschatten van het shadow-AI-risico voor uw eigen kantoor is voorzichtigheid met de statistieken die rondgaan op zijn plaats: onze audit van de meest herhaalde shadow-AI-statistieken herleidt elk cijfer naar de primaire bron en toont een aantal dat niet meet wat het meestal wordt geacht te meten.
Om AI te gebruiken zonder namen en identificatoren uit handen te geven, kan Redactic uw documenten voor AI voorbereiden: de gedetecteerde waarden worden plaatshouders en de echte namen keren terug in uw browser wanneer het antwoord binnenkomt.
7. Een maskeertool kiezen: een evaluatiechecklist met 8 punten
Koopt u software voor documentmaskering, met of zonder AI-gebaseerde detectie, of weegt u een eigen bouw af tegen een kant-en-klaar product, dan is de volgende checklist die wij met prospects gebruiken. Geef elk punt 0-2 (nee / gedeeltelijk / ja) en laat de punten over de privacypositie dubbel meetellen. Eindigt u onder 18 van de maximaal 32, dan hebt u een nalevingsrisico; onder 12 hebt u ook een productiviteitsrisico.
- Architectuur zonder sporen. Verwerkt de dienst het document in het geheugen en gooit hij het meteen weg? Is de invoer versleuteld opgeslagen in het tijdelijke geheugen, met een korte TTL, en wordt hij nooit in een permanent logboek geschreven? Waarom het ertoe doet: een bewaarde kopie is nog steeds een persoonsgegeven; het maskeerproces wordt zelf een aparte verwerkingsactiviteit als de invoer het verzoek overleeft.
- Meertalige detectie van persoonsgegevens. Herkent het model de Italiaanse Codice Fiscale, Franse NIR, Duitse Steuer-ID, Spaanse DNI/NIE, Poolse PESEL enzovoort, of alleen Engelse namen en Amerikaanse SSN's? Waarom het ertoe doet: op het Engels gerichte detectors missen 30-50% van de nationale identificatoren in EU-documenten.
- OCR voor scans. Kan de tool een gescande pdf of een gefotografeerde identiteitskaart pixelperfect zwartmaken? Waarom het ertoe doet: de gevallen waar uw functionaris voor gegevensbescherming het meest van schrikt, oude contracten en gefotografeerde documenten, zijn precies de gevallen waarbij een tool die alleen tekst aankan niet helpt.
- Ondersteuning voor twee modi. Kan de tool vanuit dezelfde upload zowel een omkeerbaar (plaatshouder) als een onomkeerbaar (zwartmaking) resultaat maken? Waarom het ertoe doet: tools met één modus dwingen u twee pijplijnen te onderhouden.
- Handmatige controle. Laat de interface een mens elk gedetecteerd fragment accepteren of afwijzen voordat de maskering wordt toegepast? Waarom het ertoe doet: detectie die op volledigheid is afgestemd is de juiste standaard, maar geeft valse positieven die een snelle controleroute nodig hebben.
- Metadata verwijderen. Verwijdert de tool ook documenteigenschappen (auteur, laatst gewijzigd door, XMP, EXIF)? Waarom het ertoe doet: het meest voorkomende lek in de praktijk is een schone tekst met een auteursnaam in de pdf-eigenschappen.
- Auditcertificaat. Maakt de tool per taak een cryptografisch verslag van wat is verwerkt, met hashes en aantallen per categorie maar zonder inhoud? Waarom het ertoe doet: het certificaat laat u zien aan de toezichthouder, de verzekeraar en de klant.
- Compliancepositie. Gegevensverblijf in de EU, DPA bij aanmelding inbegrepen, register van subverwerkers, click-wrap-toestemming met cryptografische vastlegging, rolscheiding (uw tool treedt op als verwerker, niet als verwerkingsverantwoordelijke). Waarom het ertoe doet: hiervan hangt af of de tool in uw bestaande AVG-programma past of nieuwe verwerkingsactiviteiten creëert die u dan moet beheersen.
Tools die als Chrome-extensie worden geleverd kunnen elegant zijn, maar scoren slecht op (1) en (8): achter een gratis extensie staat zelden een echte DPA. Open-sourcebibliotheken zoals Presidio of Piiranha scoren goed op (2), maar de operationele voetafdruk (geen sporen, OCR, audit, certificaat), het grootste deel van het werk, ligt dan bij u. Commerciële gehoste tools scoren wisselend; de vraag die u moet stellen is: “toon mij het certificaat van een voorbeeldtaak en de lijst van subverwerkers.”
Bouwen of kopen vraagt om aandacht voor documentverwerking, controle door mensen, validatie van resultaten, bewaarregels, toegangsbeheer, contractuele documentatie en doorlopende ondersteuning. Een detectieprototype is slechts een deel van een onderhouden dienst. Vergelijk de totale operationele inspanning met de eisen van uw organisatie aan de hand van representatieve documenten.
Redactic combineert automatische detectie, documentverwerking en controle door mensen om gevoelige informatie te helpen vinden, ook in ondersteunde gescande documenten. Controleer gedetecteerde waarden voordat u permanent of omkeerbaar maskeren toepast. De dekking hangt af van documentkwaliteit, taal en context; automatisering kan informatie missen. Beoordeel representatieve bestanden en geëxporteerde resultaten voordat u een workflow invoert. Meer lezen: DPA
Belangrijke beperkingen: het exportformaat en het behoud van de opmaak hangen af van de gekozen workflow. Scans, gedeeltelijke namen, alternatieve spellingen en contextuele identificatoren kunnen leiden tot gemiste of inconsistente detecties. Controleer deze gevallen en het uiteindelijke geëxporteerde bestand. Voor omkeerbaar herstel kan een koppeling nodig zijn, die apart beschermd moet worden.
8. Veelgestelde vragen
Wat is het verschil tussen gegevensmaskering en gegevensanonimisering?
Maskeren haalt geselecteerde informatie uit een resultaat. Omkeerbaar maskeren vervangt gedetecteerde waarden en gebruikt een koppeling om ze te herstellen. Permanent maskeren maakt het resterende document niet automatisch anoniem: informatie uit de context kan personen nog steeds identificeren. Beoordeel de identificeerbaarheid apart voordat u een resultaat als anoniem behandelt.
Is pseudonimisering hetzelfde als versleuteling?
Nee. Versleuteling kan door iedereen met de sleutel worden teruggedraaid en is een beveiligingsmaatregel; pseudonimisering vervangt identificerende waarden door plaatshouders en houdt de omgekeerde koppeling onder strengere toegangscontrole. De AVG erkent pseudonimisering uitdrukkelijk in art. 4, punt 5, en art. 32, lid 1, onder a; versleutelde persoonsgegevens blijven persoonsgegevens.
Kan ik ChatGPT onder de AVG veilig gebruiken met gemaskeerde documenten?
Maskeren kan de hoeveelheid persoonsgegevens verkleinen die met een AI-aanbieder wordt gedeeld, maar maakt een gebruik niet automatisch rechtmatig. Controleer de voorbereide inhoud, inclusief extra instructies, bevestig de voorwaarden van de aanbieder en beoordeel het doel, de rechtsgrond en de resterende context. In Redactic SaaS worden documenten voor verwerking naar Redactic geüpload voordat een apart gekozen optionele AI-taak wordt uitgevoerd.
Werkt automatische detectie van persoonsgegevens op gescande pdf's?
OCR kan helpen om tekst in gescande pdf's en afbeeldingen te detecteren. Redactic ondersteunt documentworkflows met scans, afhankelijk van de ondersteunde formaten en talen. Controleer pagina's van slechte kwaliteit en geëxporteerde resultaten; OCR en automatische detectie kunnen gevoelige informatie missen.
Hoe lang moet de plaatshouderkoppeling worden bewaard?
Bewaar een herstelkoppeling alleen zolang en voor zover uw werkwijze dat vereist, en bescherm de toegang ertoe. Raadpleeg de toepasselijke overeenkomst voor de voorwaarden van Redactic voor tijdelijke verwerking en verwijdering. Een koppeling die u zelf downloadt of bewaart, vraagt om een eigen beleid voor omgang en bewaring.
Wat is shadow AI en waarom is het een AVG-probleem?
Shadow AI is het gebruik van openbare LLM-diensten met gevoelige gegevens, buiten het zicht van IT, meestal via persoonlijke accounts. Het leidt tot verwerking zonder verwerkersovereenkomst (art. 28), niet-gedocumenteerde doorgifte naar derde landen (Schrems II) en mogelijke blootstelling van de invoer bij het trainen van modellen. Wat werkt is een officiële route die sneller en veiliger is dan de schaduwroute, want verboden worden omzeild.
Verandert de EU-verordening kunstmatige intelligentie iets aan maskeren?
Ja. AI-systemen met een hoog risico uit bijlage III (hr, werving, functioneringsbeoordeling) moeten voldoen aan de verplichtingen voor datagovernance (art. 10), risicobeheer (art. 9) en menselijk toezicht (art. 14). Invoergegevens pseudonimiseren voordat ze naar zo'n systeem gaan, is de zuiverste manier om gegevensminimalisatie uit art. 5 AVG en art. 10 van de AI-verordening tegelijk te halen. De AI-verordening schrijft maskeren niet uitdrukkelijk voor, maar maakt het in de praktijk makkelijker.
Wat is een maskeringscertificaat en waarom heb ik er een nodig?
Een maskeringscertificaat kan uw registratie van bewerkingen aanvullen met documenthashes en samenvattingen van het maskeren. Het bewijst niet dat elke gevoelige waarde is gedetecteerd, stelt geen anonimisering vast en bewijst niet onafhankelijk dat geen kopie van een document is bewaard. Leg de velden van het daadwerkelijke certificaat naast uw auditvereisten.
Kan ik een Excel-sheet met personeelsgegevens maskeren zonder de formules te breken?
Redactic ondersteunt workflows voor het maskeren van spreadsheets. Test een representatieve werkmap en controleer de geëxporteerde bladen, formules, getalwaarden, opmaak en eigenschappen. Ga er niet van uit dat elke spreadsheetfunctie behouden blijft of dat alle gevoelige informatie is gedetecteerd.
Waar slaat Redactic mijn gegevens op?
Documenten en resultaten gebruiken tijdelijke verwerkingsopslag op infrastructuur in Europa die Redactic beheert. Bij het herstellen kan tijdelijke verwerking van herstelgegevens aan de serverkant een rol spelen. Account-, facturatie-, toestemmings- en bewerkingsregistraties worden apart behandeld. Raadpleeg de verwerkersovereenkomst (DPA) en de privacyverklaring van Redactic voor bewaar- en verwijdervoorwaarden en vraag ons het profiel voor uw werkwijze te bevestigen. Meer lezen: vertrouwenspagina's
Leest u uit deze gids maar één ding, lees dan onderdeel 6 over shadow AI. Het grootste enkele risico voor uw kantoor in 2026 is het opgetelde effect van duizend kleine ChatGPT-plakacties vanaf persoonlijke accounts. Het antwoord is een snellere officiële route met goede gegevensmaskering en een ondertekende DPA, want strengere regels worden omzeild. Bouw die route voordat de toezichthouder het voor u doet.
Wilt u zien hoe dit in de praktijk werkt, dan loopt de startpagina van Redactic de vier gebruiksmodi door (Maskeren, Anonimiseren, Gebruiken met AI, Beveiligde chatbot) met een livedemo op een voorbeeldcontract. Het Solo-abonnement dekt één professional voor 19 euro per maand; het Firm-abonnement voegt de beveiligde AI-chat en maximaal vijftig gebruikers toe voor 49 euro per maand; Enterprise is maatwerk. De DPA wordt bij aanmelding ondertekend en het maskeringscertificaat kunt u bij elke afgeronde taak downloaden.